Inforlandia desenvolve nova plataforma de IA de elevado desempenho com 4× NVIDIA H200 NVL
Uma plataforma desenvolvida para IA de elevada exigência
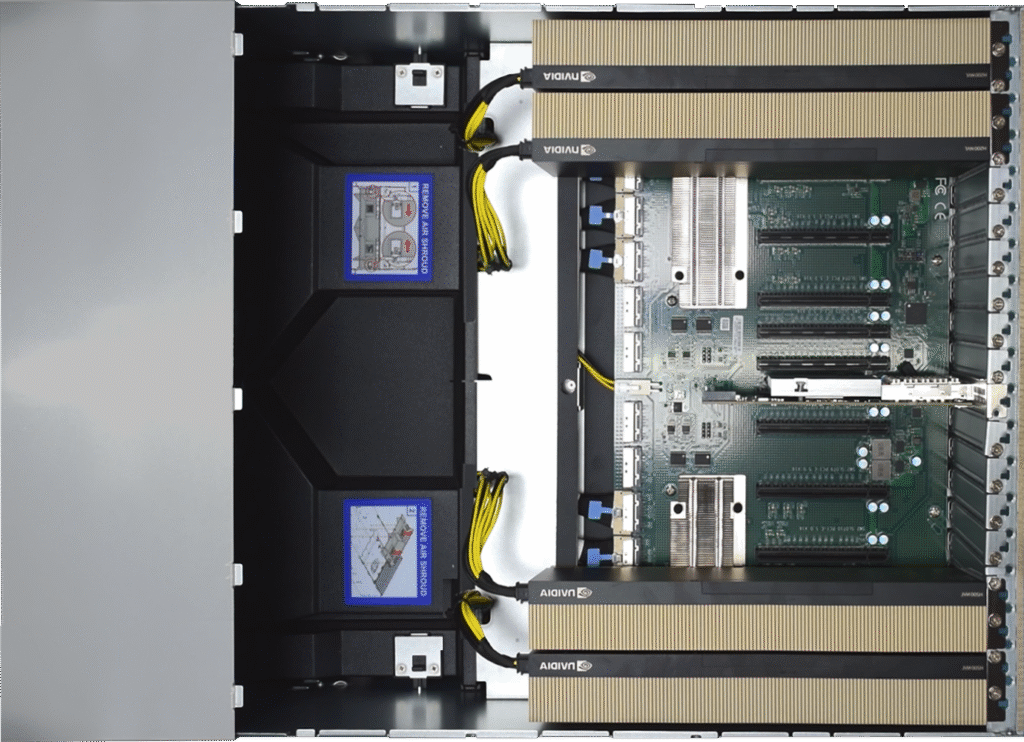
- 4× NVIDIA H200 NVL, com 141 GB de HBM3e por GPU;
- 564 GB de VRAM total;
- 2× Intel Xeon Gold 6530, com 64 núcleos / 128 threads;
- 503 GiB de memória DDR5;
- 3,5 TiB de armazenamento NVMe;
- 2× 10 GbE + 2× NDR400 InfiniBand / 400 GbE;
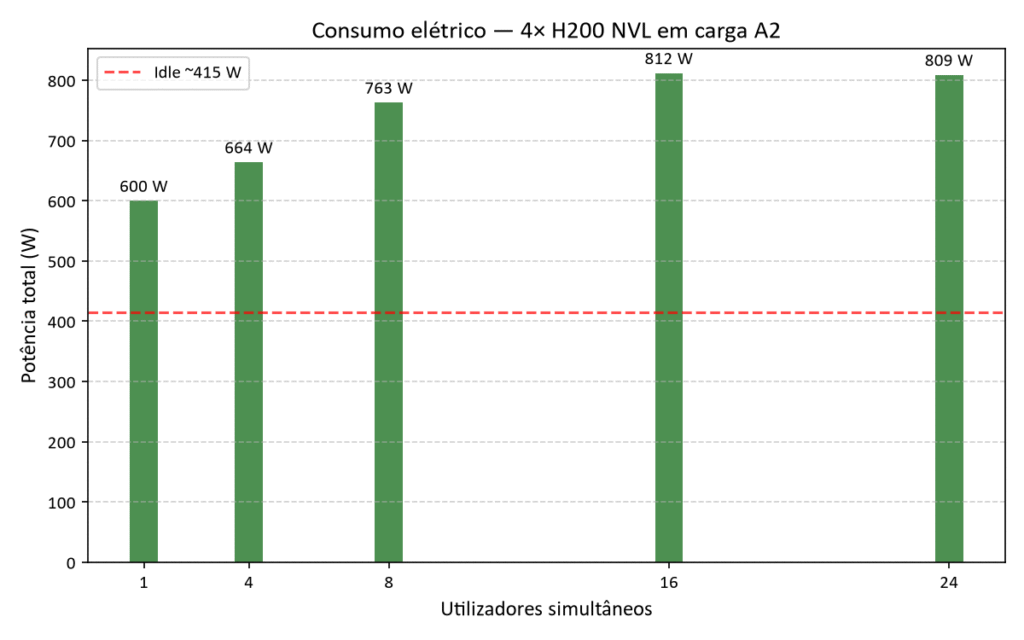
- 3× fontes de alimentação redundantes de 3200 W, com eficiência Titanium;
- Gestão dedicada através de BMC/IPMI;
- Ubuntu 22.04 LTS.
LLM, imagem e vídeo numa única infraestrutura
- vLLM, com API OpenAI para o modelo
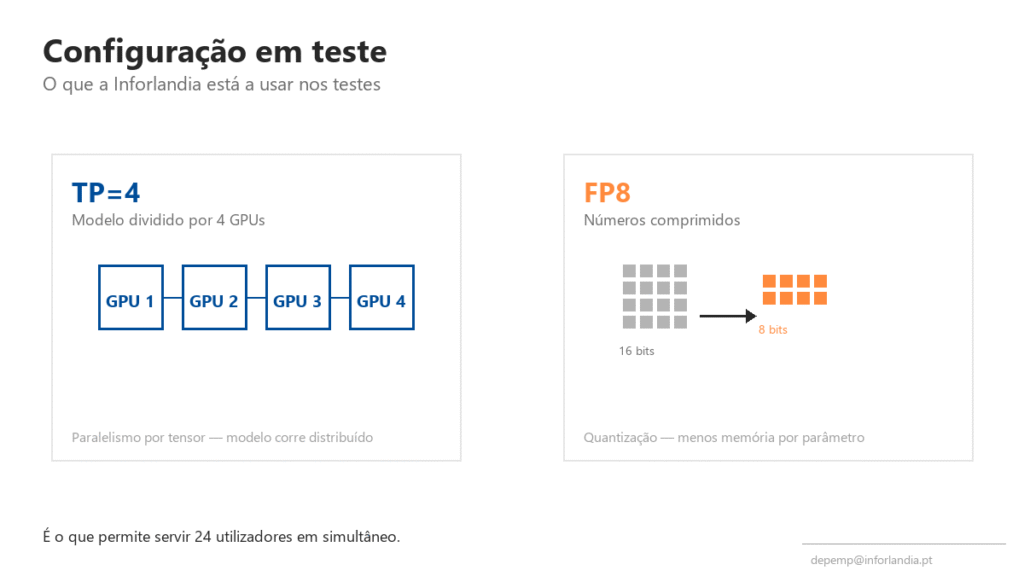
Qwen3.8-27B-FP8, utilizando as quatro GPUs em tensor parallel; - Open WebUI, para interação com os modelos através de uma interface web;
- ComfyUI + FLUX, para geração e edição de imagens;
- Cosmos3, para geração de vídeo.
Desempenho validado em cenários de utilização real
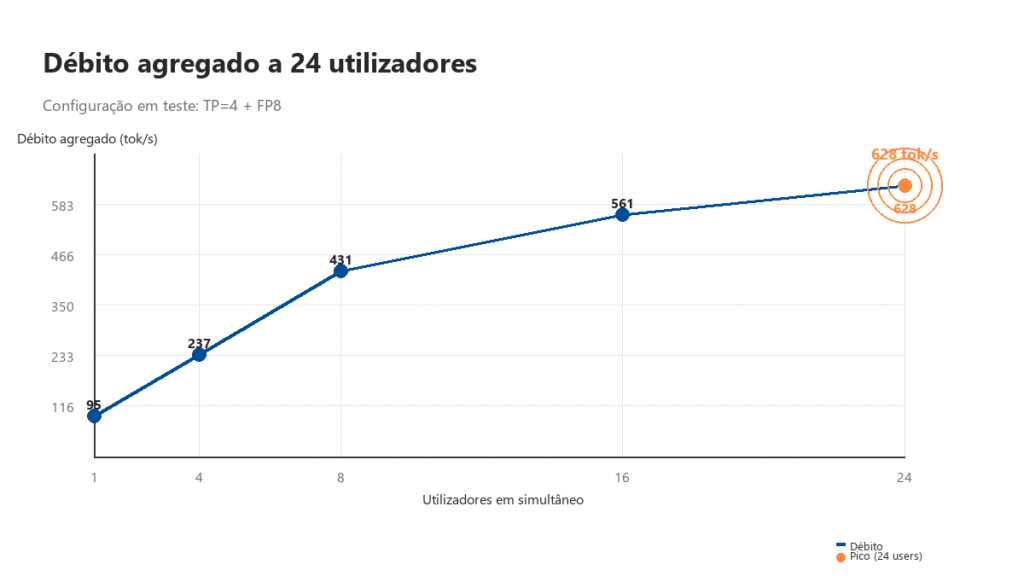
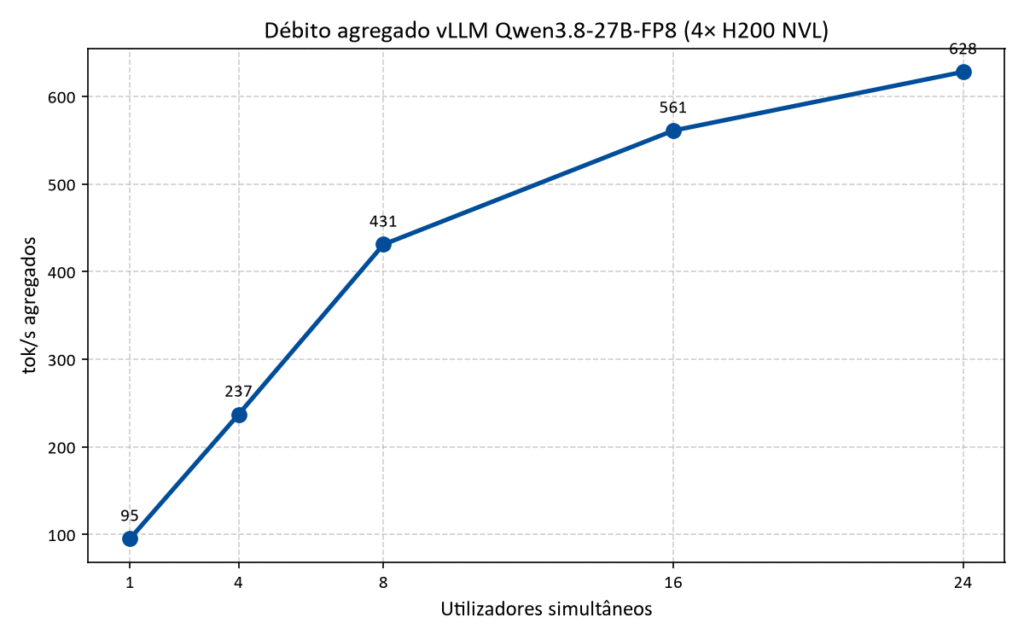
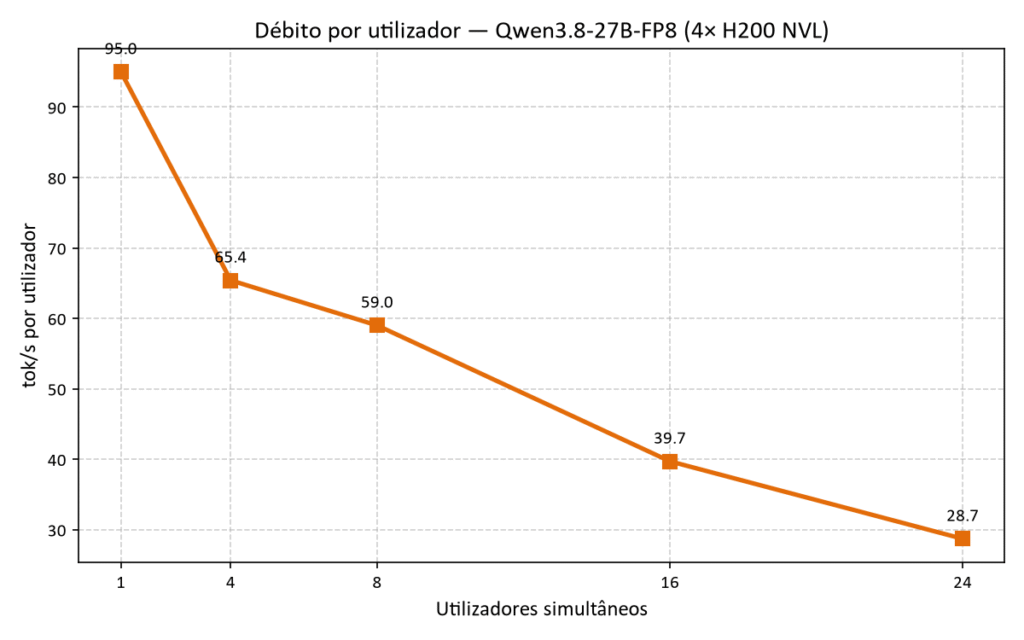
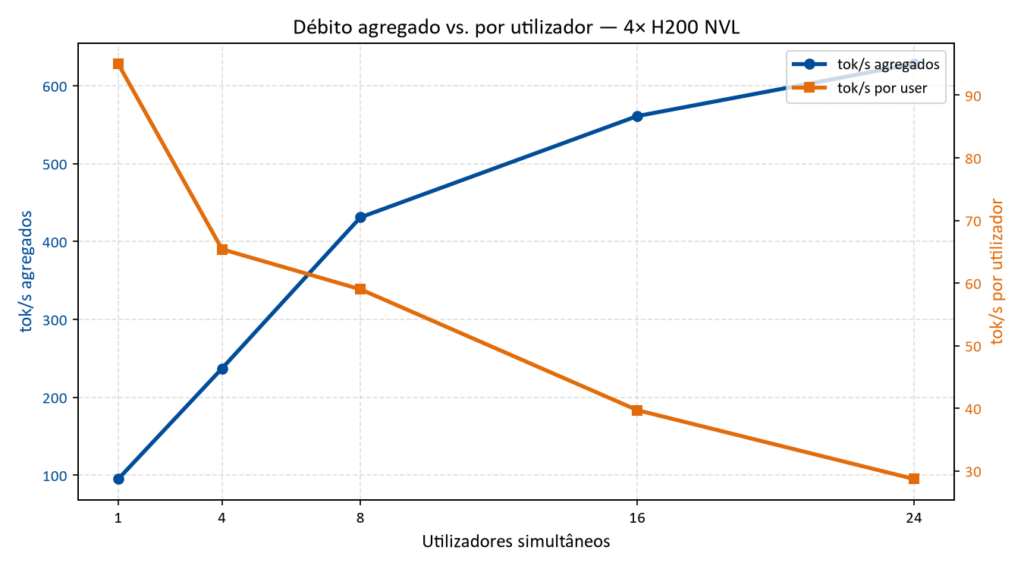
- 95 tok/s com 1 utilizador;
- 237 tok/s com 4 utilizadores;
- 431 tok/s com 8 utilizadores;
- 561 tok/s com 16 utilizadores;
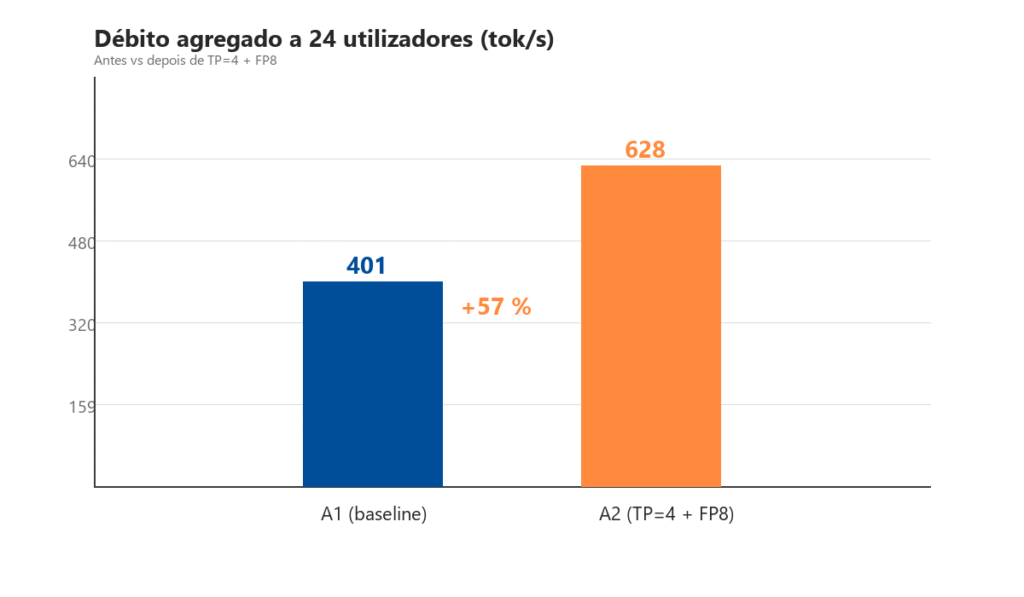
- 628 tok/s agregados com 24 utilizadores simultâneos.
IA on-premise para investigação e produção
Uma infraestrutura pensada à medida da aplicação
FAQ
Um servidor de IA é uma infraestrutura de computação dimensionada para executar aplicações e modelos de Inteligência Artificial, recorrendo normalmente a GPUs de elevado desempenho e elevada capacidade de memória.
Uma infraestrutura de IA on-premise permite executar modelos e aplicações de Inteligência Artificial na infraestrutura da própria organização, proporcionando maior controlo sobre o ambiente de execução, os dados e a operação.
A plataforma foi validada com uma stack que inclui vLLM, Open WebUI, ComfyUI + FLUX e Cosmos3, permitindo concentrar workloads de LLM, geração de imagem e geração de vídeo numa única infraestrutura.
Nos testes realizados, a plataforma atingiu 628 tokens por segundo agregados com 24 utilizadores simultâneos, utilizando o cenário de teste com prompts médios.
Sim. O posicionamento que esta página deve comunicar é precisamente a capacidade de dimensionar e configurar infraestruturas de IA de acordo com os modelos, aplicações e necessidades de cada organização.